PRLab → SEO-блог → Индексация Google
Почему страница не индексируется в Google
Страница не индексируется в Google не обязательно из-за одной критической ошибки. Поисковик сначала должен обнаружить URL, получить доступ к контенту, выбрать его канонической версией и решить, что документ полезен для выдачи. Эта последовательность помогает найти реальную причину без случайных правок.
Как Google решает, индексировать ли страницу
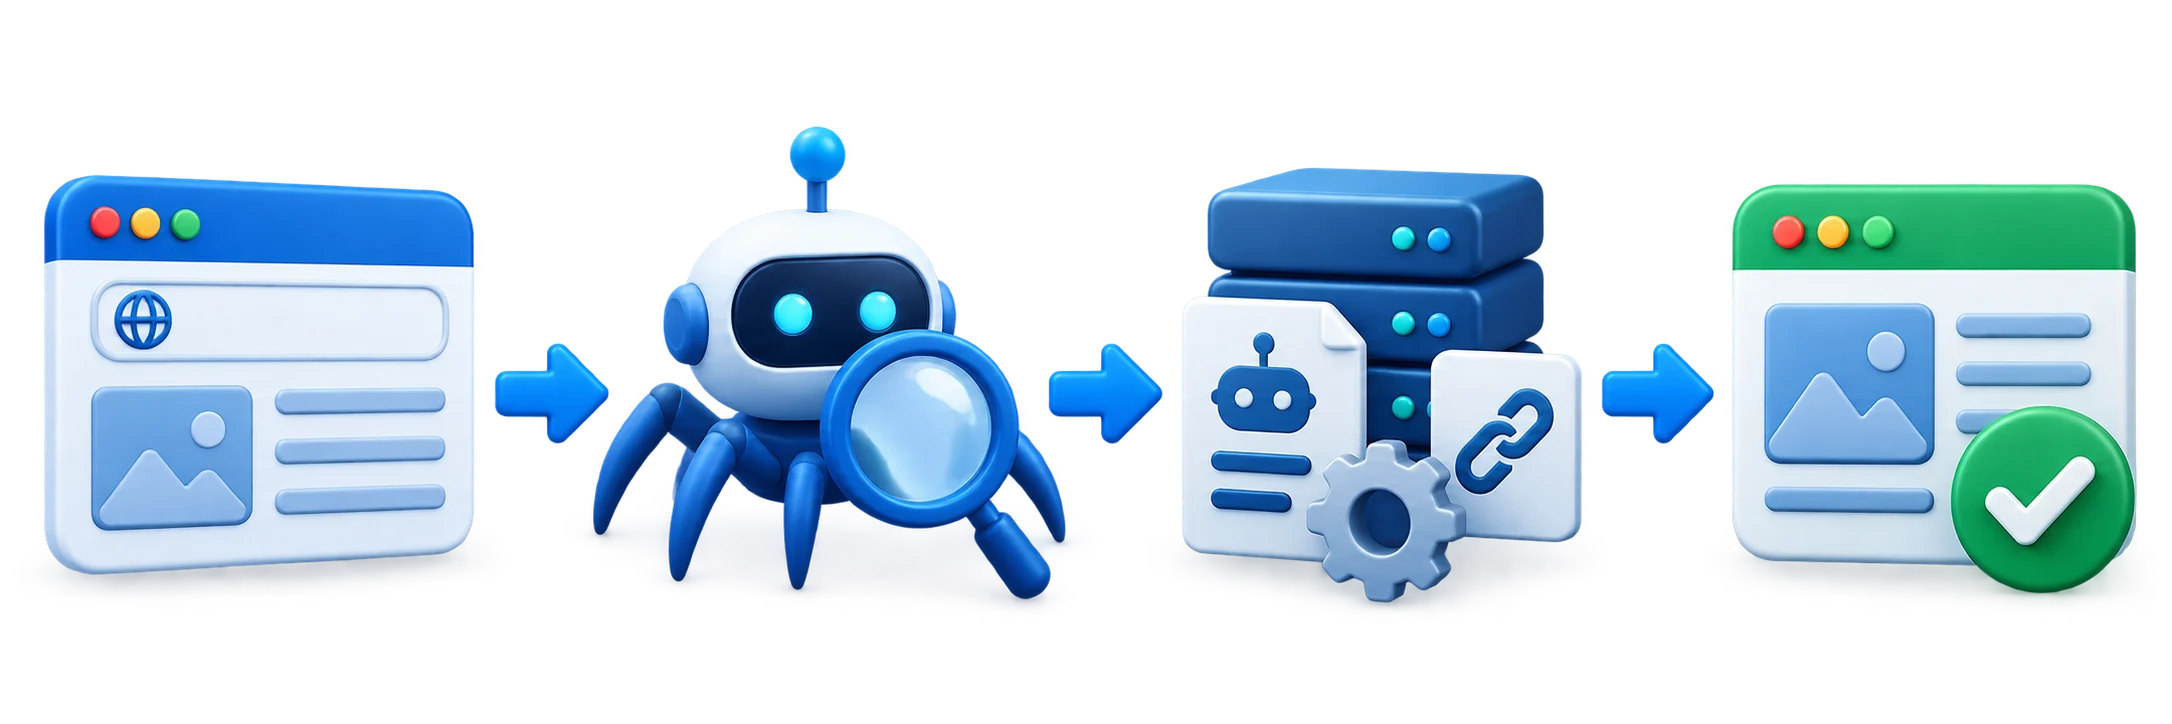
Google не добавляет в индекс каждый найденный URL. Сначала робот узнаёт о странице из ссылки, sitemap.xml или другого источника. Затем сервер должен отдать корректный ответ, robots.txt не должен запрещать обход, а метатег robots — запрещать индексирование. После этого система сопоставляет документ с дублями и выбирает canonical.
Семантика статьи
Основной кластер: «почему страница не индексируется в Google», «страница не в индексе Google», «как добавить страницу в индекс Google». Дополняющие запросы: Google Search Console индексирование, noindex, robots.txt, canonical, просканировано но не проиндексировано, URL не найден. Это запросы о диагностике и безопасном исправлении причин.
Не путайте индексацию и позицию
Проиндексированный URL может не ранжироваться по нужной фразе, а высокоранжируемая страница иногда временно исчезает из-за переобхода. Сначала подтвердите, что Google знает страницу, затем оценивайте её видимость через проверку позиций по ключевым словам и истории изменений.
Как проверить страницу: последовательность действий
1. Откройте проверку URL в Search Console
Это главный источник для конкретного адреса. Введите финальный URL и посмотрите: есть ли он в Google, когда был последний обход, выбран ли canonical, разрешена ли индексация и может ли Google получить страницу. Сохраните точный статус, а не только общий вывод.
2. Проверьте HTTP-код и доступность
Страница должна стабильно возвращать 200. Коды 301 и 302 ведут на другой адрес, 404 и 410 говорят об отсутствии ресурса, 5xx мешают обходу. Используйте проверку HTTP-ответа страницы, а при массовой проблеме — инструкцию по поиску URL с кодами 301, 302 и 500.
3. Проверьте robots.txt и meta robots
Запрет Disallow блокирует обход, а noindex запрещает показ URL в индексе. Иногда они остаются после разработки, миграции или запуска фильтров. Для чтения правил пригодится разбор robots.txt перед поисковой индексацией. Не закрывайте robots.txt страницу, с которой одновременно хотите снять noindex: роботу нужно увидеть изменившийся тег.
4. Проверьте canonical и редиректы
Если canonical указывает на другой URL, Google обычно выберет его. Сравните HTTP- и HTTPS-версии, адреса с www, параметры, слеш в конце, пагинацию и версии для печати. В sitemap.xml и внутренних ссылках должен использоваться выбранный финальный адрес.
Основные причины, почему Google не индексирует страницу
| Сигнал | Что означает | Что сделать |
|---|---|---|
| Исключена тегом noindex | Страница прямо запрещена для индекса | Уберите noindex, если URL должен быть в выдаче |
| Заблокирована robots.txt | Робот не может корректно обойти документ | Откройте нужный путь для Googlebot |
| Дубль без выбранного canonical | Поисковик выбрал другую версию | Настройте canonical и единые ссылки |
| Просканировано, но не проиндексировано | Google пока не видит достаточной ценности | Улучшите содержание и внутренние связи |
| Ошибка сервера | Обход нестабилен | Исправьте 5xx и повторно проверьте URL |
Полезное правило
Когда проблема в содержании, а не в настройках
Технически доступный URL может не попасть в индекс, если он почти повторяет другую страницу, не отвечает на самостоятельный вопрос или содержит слишком мало оригинальной информации. Особенно часто это встречается у фильтров, городских вариаций, карточек с одинаковыми описаниями и автоматически созданных разделов.
Что улучшить
- сформулировать отдельный интент и ясный H1;
- добавить факты, примеры, условия, изображения или ответы на вопросы;
- убрать копирование описаний между близкими URL;
- дать странице место в структуре и тематические внутренние ссылки;
- проверить, что текст не переоптимизирован.
Для структуры используйте проверку страниц без H1 и неверной иерархии заголовков, а для текста — анализ употребления ключевых слов без переспама. Внутренний путь тоже важен: короткий анкор «проверка индексации», средний — «страница не в Google» и длинный: как проверить внутреннюю перелинковку и найти полезные URL без входящих ссылок помогают связать статью с нужным контекстом.
Чего делать не нужно
Не создавайте десятки почти одинаковых страниц, не копируйте чужие тексты и не отправляйте на переобход каждый URL каждый день. Google не обязан индексировать служебные, тонкие или дублирующие документы — иногда правильное решение, наоборот, оставить их вне поиска.
План исправления и контроль результата
- Подтвердите статус URL в Search Console.
- Проверьте код ответа, robots, noindex, canonical и редиректы.
- Сверьте ссылочный путь и sitemap.xml.
- Устраните дубли или сделайте страницу самодостаточной.
- Добавьте тематические внутренние ссылки.
- После исправления запросите проверку URL и наблюдайте статус.
Отслеживайте не только факт индексации. После попадания в индекс URL должен получать показы, клики и соответствовать запросам. Чтобы оценить общее покрытие сайта, прочитайте как узнать количество страниц сайта в поиске и объяснить расхождения между sitemap и индексом.
Индексация требует времени: скорость зависит от истории домена, качества сайта и частоты обхода. Последовательная диагностика безопаснее случайных «ускорителей» и даёт устойчивый результат.
Сноски и пояснения
- Google описывает отчёт Page Indexing и проверку URL как основные средства диагностики статусов индексации. Статусы отражают причину исключения, но требуют интерпретации в контексте конкретной страницы. Документация Google Search Central. ↩